
Enhancing Fault Tolerance in Exascale Systems: Algorithm-Based Approaches

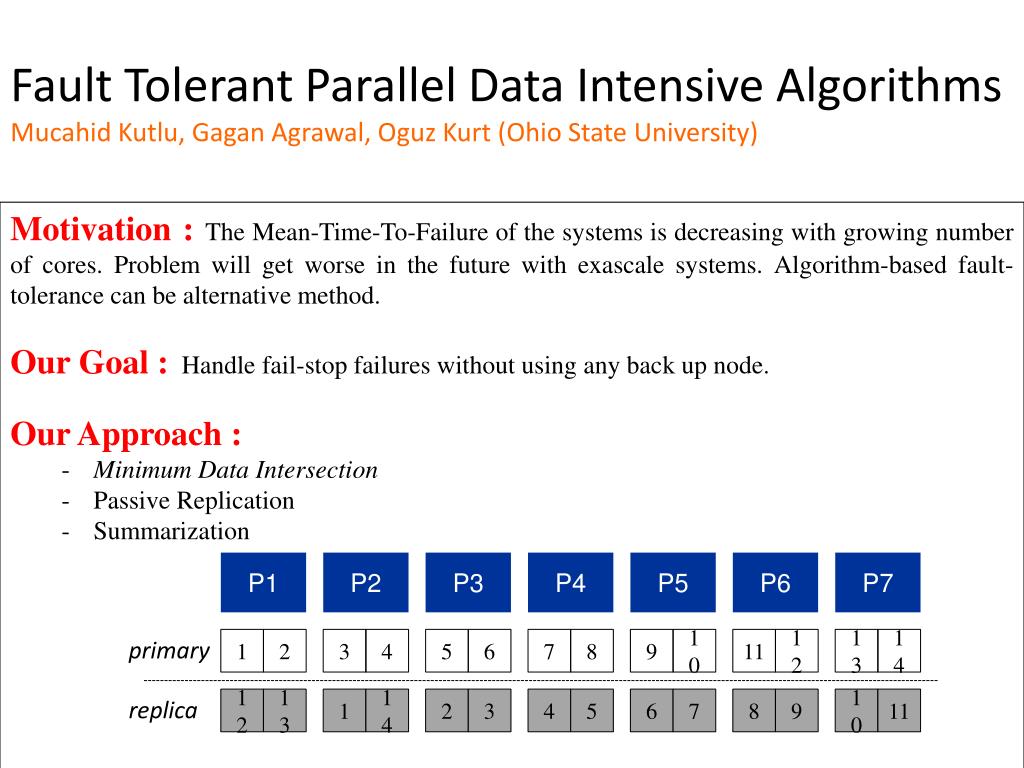
As the number of cores in systems increases, the Mean Time To Failure (MTTF) decreases, posing severe challenges in future exascale computing environments. Our research aims to address fail-stop failures without deploying backup nodes, focusing on algorithm-based fault tolerance. We explore methods like Minimum Data Intersection, Passive Replication, and summary-based techniques in developing fault-tolerant parallel data-intensive algorithms. Our experimental results reveal the impact of summary exchange frequency on total execution time amid varying failures, offering promising solutions for resilient computing.
Télécharger la présentation 
Politique de téléchargement : le contenu du site vous est fourni TEL QUEL pour votre information et votre usage personnel ; il ne peut être vendu, concédé sous licence ni partagé sur d’autres sites sans l’accord de son auteur.Le contenu vous est fourni TEL QUEL, pour votre information et votre usage personnel uniquement. Téléchargez la présentation en cliquant sur ce lien. Lors du téléchargement, si vous ne parvenez pas à télécharger une présentation, l’éditeur a peut-être supprimé le fichier de son serveur.Pendant le téléchargement, si vous ne parvenez pas à obtenir une présentation, le fichier a peut-être été supprimé par l’éditeur.
F I N